起因是在 Telegram 频道里刷到一个同栈项目 EdgeBlog(作者 nyoungo):一样跑在 Cloudflare Pages 上、一样用 D1 存数据、R2 存媒体。项目很新——2026 年 10 月才建仓,Star 还不多——但细看它的功能单子,有好几处确实做得比我这个 ym-blog 好。与其眼馋,不如动手:这一版(v1.1.0)把人家的四个长处逐项借了过来,外加一个小升级。这篇是升级记录,也是给后来者的对照笔记。
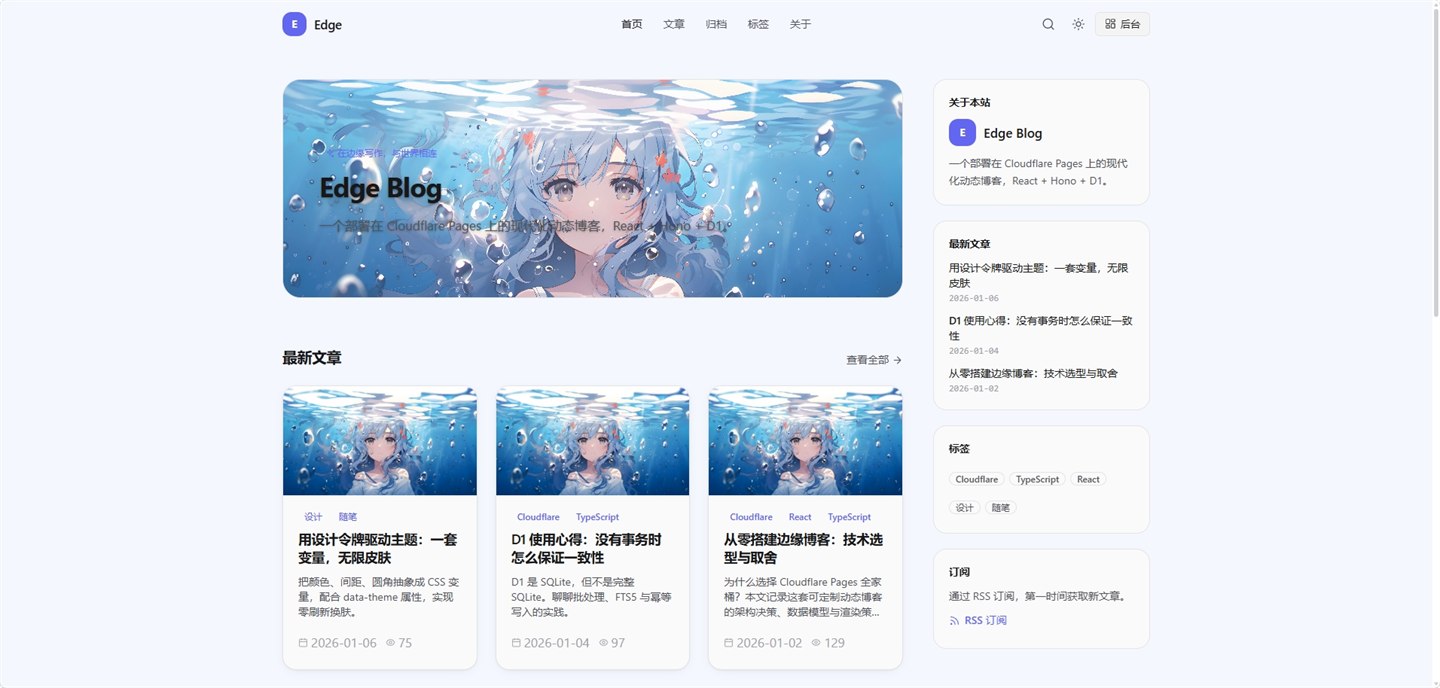
项目地址:github.com/nyoungo/EdgeBlog · 在线演示:www.068800.xyz
第一件:中文全文搜索,终于不用全表扫了
原来:本站搜索是拿关键词对标题、摘要、正文做子串匹配(LIKE),文章少的时候没问题,但每搜一次就把所有文章正文扫一遍,文章多了既慢又费数据库额度,而且结果只能按时间排,谈不上「相关」。
现在:学 EdgeBlog 的做法,给文章建了一张全文索引表(FTS5 + trigram 分词):中文按 3 个字一片切开建索引,搜正文里任意一段话都能命中,结果按相关度排序。发布、改稿、删稿都由数据库触发器自动同步索引,不用人管。
兜底也留好了:两个字的短词(切不出 3 字片段)、索引还没建好、索引没命中这三种情况,会自动退回原来的子串匹配——升级只有升,没有降。读者侧无感:搜索框还是那个搜索框,只是现在搜正文深处的一个词组也能把文章捞出来。
第二件:AI 写作管道(只做管道,Key 自己备)
原来:没有。摘要全靠手写,正文全靠手打。
现在:后台「站点设置」里多了一张「AI 写作」卡:填服务地址(Base URL)、密钥(API Key)、模型名、温度,再加上两套可改的提示词(生成摘要用一套、生成正文用一套)。保存后,文章编辑器的工具条上多了两个按钮——「AI 生成摘要」会把生成的摘要填进摘要框,「AI 生成正文」会把生成内容追加到正文末尾,改不改、用不用都在自己手里。
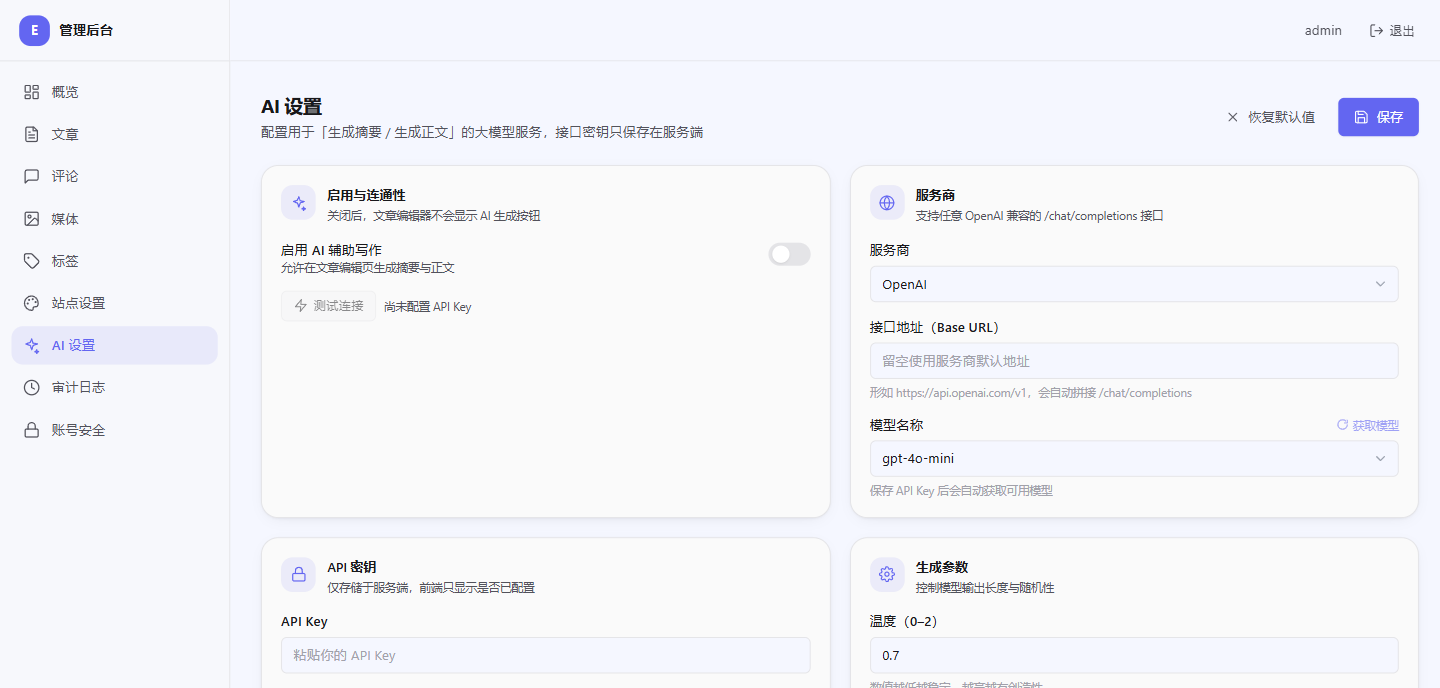
图:EdgeBlog 本家的 AI 设置页长这样——它把 AI 做成了一个独立设置页;本站借的是同一套思路,落地时收成了站点设置里的一张「AI 写作」卡。
几个刻意的设计:
- 只接 OpenAI 兼容接口:OpenAI、DeepSeek、各类中转都能接,不绑定任何一家。
- 密钥只存服务端:接口永远只回「配没配」,页面上看不到明文;保存时留空不会把已存的密钥冲掉。
- 没配置不装死:没填配置就点按钮,会明确告诉你「去站点设置 → AI 写作填地址和密钥」,而不是转圈或者弹一串看不懂的报错。
顺带记一个真实踩到的坑:AI 服务出错时,我原本按惯例返回 502 状态码,结果发现经本站域名访问时,502 会被 Cloudflare 边缘替换成它自己的纯文本错误页,后台根本读不到我写的中文提示;绕了一圈定位到原因后改用 424,提示才完整送达。以后谁在 Cloudflare 上做同类代理接口,这个坑可以提前避开。
第三件:编辑器能拖拽上传了
原来:正文里插图只能粘贴、或者点按钮从文件里选。
现在:把图片、视频文件直接拖进正文框,松手就直传并插入,拖拽时正文框会高亮提示。和粘贴共用同一条直传通道,文件照样不经过服务器中转。算是补齐了一个早就该有的小体验。
第四件:配色预设,一键换主题色
原来:换主题色要在设置页自己填十六进制色值,不知道填什么好看就只能抄别人的。
现在:主题色旁边加了 6 套挑好的预设色板——活力橙、海洋蓝、葡萄紫、森系绿、湖水青、玫红——点一下换上,保存即全站生效。当然,原来自己填色值的口子还留着。
EdgeBlog 的外观定制比这细得多(连首页模块排序、Hero 大图样式都能在后台调),本站只取了「预设配色」这一层:够用,而且不伤筋骨。
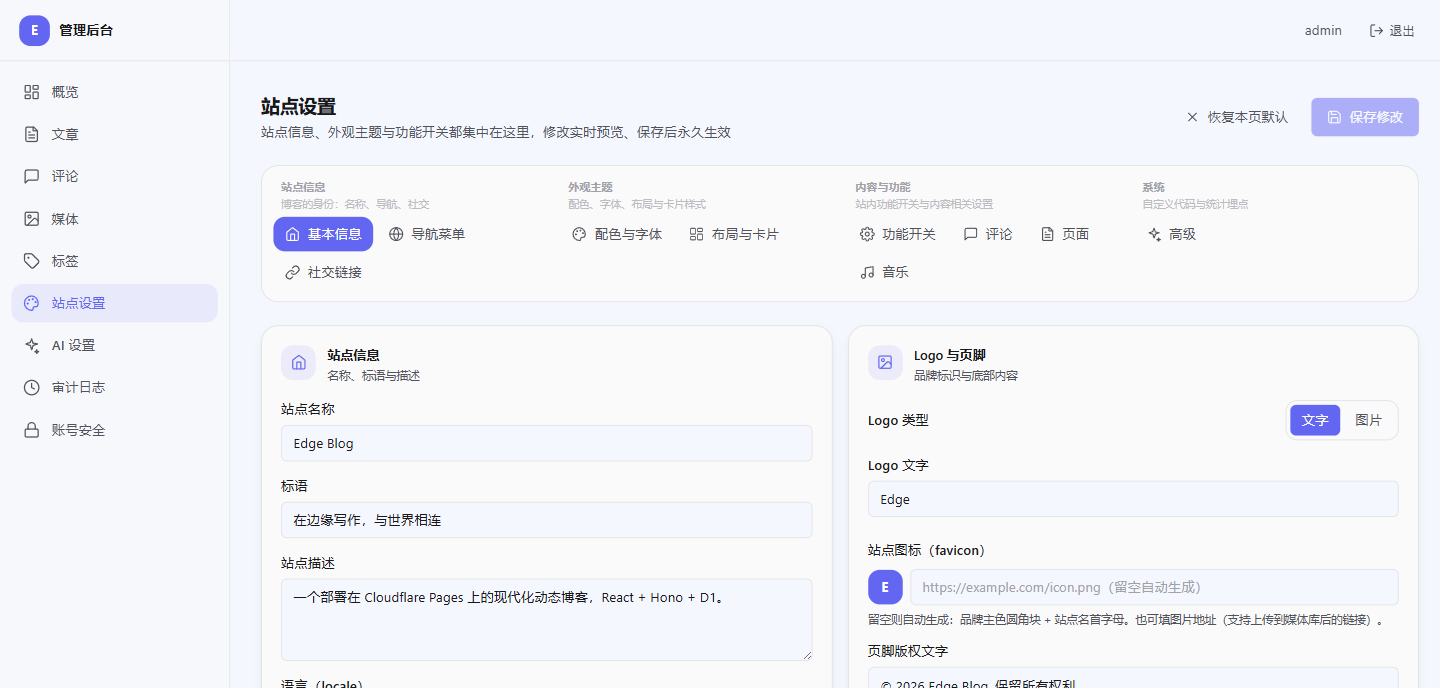
图:EdgeBlog 的外观设置页——配色只是其中一项,布局、Hero、卡片样式都能在后台调。本站只取了「预设配色」这一层,其余的先眼馋着。
附带的小升级:密码哈希懒升级
EdgeBlog 用的是 PBKDF2 高迭代哈希。本站盘点后结论是不换算法:本站现用的 scrypt(加服务端胡椒)本身并不比它弱,换过去反而是折腾。但它「登录时自动升级旧哈希」的思路值得学,于是本站补上了这条通道:以后无论是老格式记录还是将来再升参数,站长只要正常登录一次,库里的哈希就自动换成当前参数,用户全程无感。
没搬的部分,以及一个取舍
- 整站架构不换。EdgeBlog 是 React 单页应用,外观可视化程度高;本站是服务端直出页面,胜在打开快、分享抓取友好、无人值守体系(双通道备份、看门狗巡检、三层恢复)是自家攒下的家底。各有取舍,搬家不划算,好点子逐项借鉴才是正解。
- 一个必须如实说的取舍:全文索引(FTS5 虚拟表)和 Cloudflare 官方的「整库导出」被平台判为互斥——库里有虚拟表,整库导出会被直接拒绝。本站的每周备份有两条通道:主通道是按表导出 JSON,本来就不包含可重建的索引表,不受影响、已实测照常出包;次通道(整库导出)已在工作流里改成识别这个错误后降级跳过,不会每周误报失败。恢复数据后重跑一次索引脚本就能把搜索索引重建回来。这个取舍写在仓库的「已知边界」里,不藏着。
验证情况
老规矩,改完不算数、测过才算:本地冒烟脚本扩到 147 项全过(含全文搜索命中/兜底、AI 未配置提示与配好后的生成、老哈希登录后自动升级);上线后全功能又实测了两遍——搜索的边界输入(引号、百分号、单字、超长词)、改稿后索引同步、评论发表到审核全链路、媒体直传回读、定时发布、备份出包都逐项过了一遍。AI 的真实生成效果要等站长自己填了 Key 才能验,这一点不糊弄:管道已通、提示已备,Key 在设置页等着。
致谢
好点子来自 EdgeBlog(MIT 协议,作者 nyoungo),本文封面图亦出自其仓库的界面截图。开源的好处就是这样:你做好一处,别人就能借走一处;本站这版的改动也已同步写进 ym-blog 仓库的功能清单与版本历史,欢迎对照。
还没有评论,来抢沙发。